


See the original English version of this article here
ใคร ๆ ต่างก็พูดถึง Prompt Engineering แต่ถ้าคุณเคยพัฒนาระบบ AI ระดับโปรดักชัน (Production AI) คุณจะตระหนักได้ทันทีว่า “Prompt” เป็นเพียงแค่ตัวแปรเล็ก ๆ ในสมการทั้งหมดเท่านั้น
จุดชี้วัดที่สร้างความแตกต่างระหว่างแอปพลิเคชัน AI ธรรมดากับแอปพลิเคชันระดับท็อป ไม่ใช่ Prompt แต่คือ “Context (บริบท)” ที่คุณป้อนให้กับโมเดล
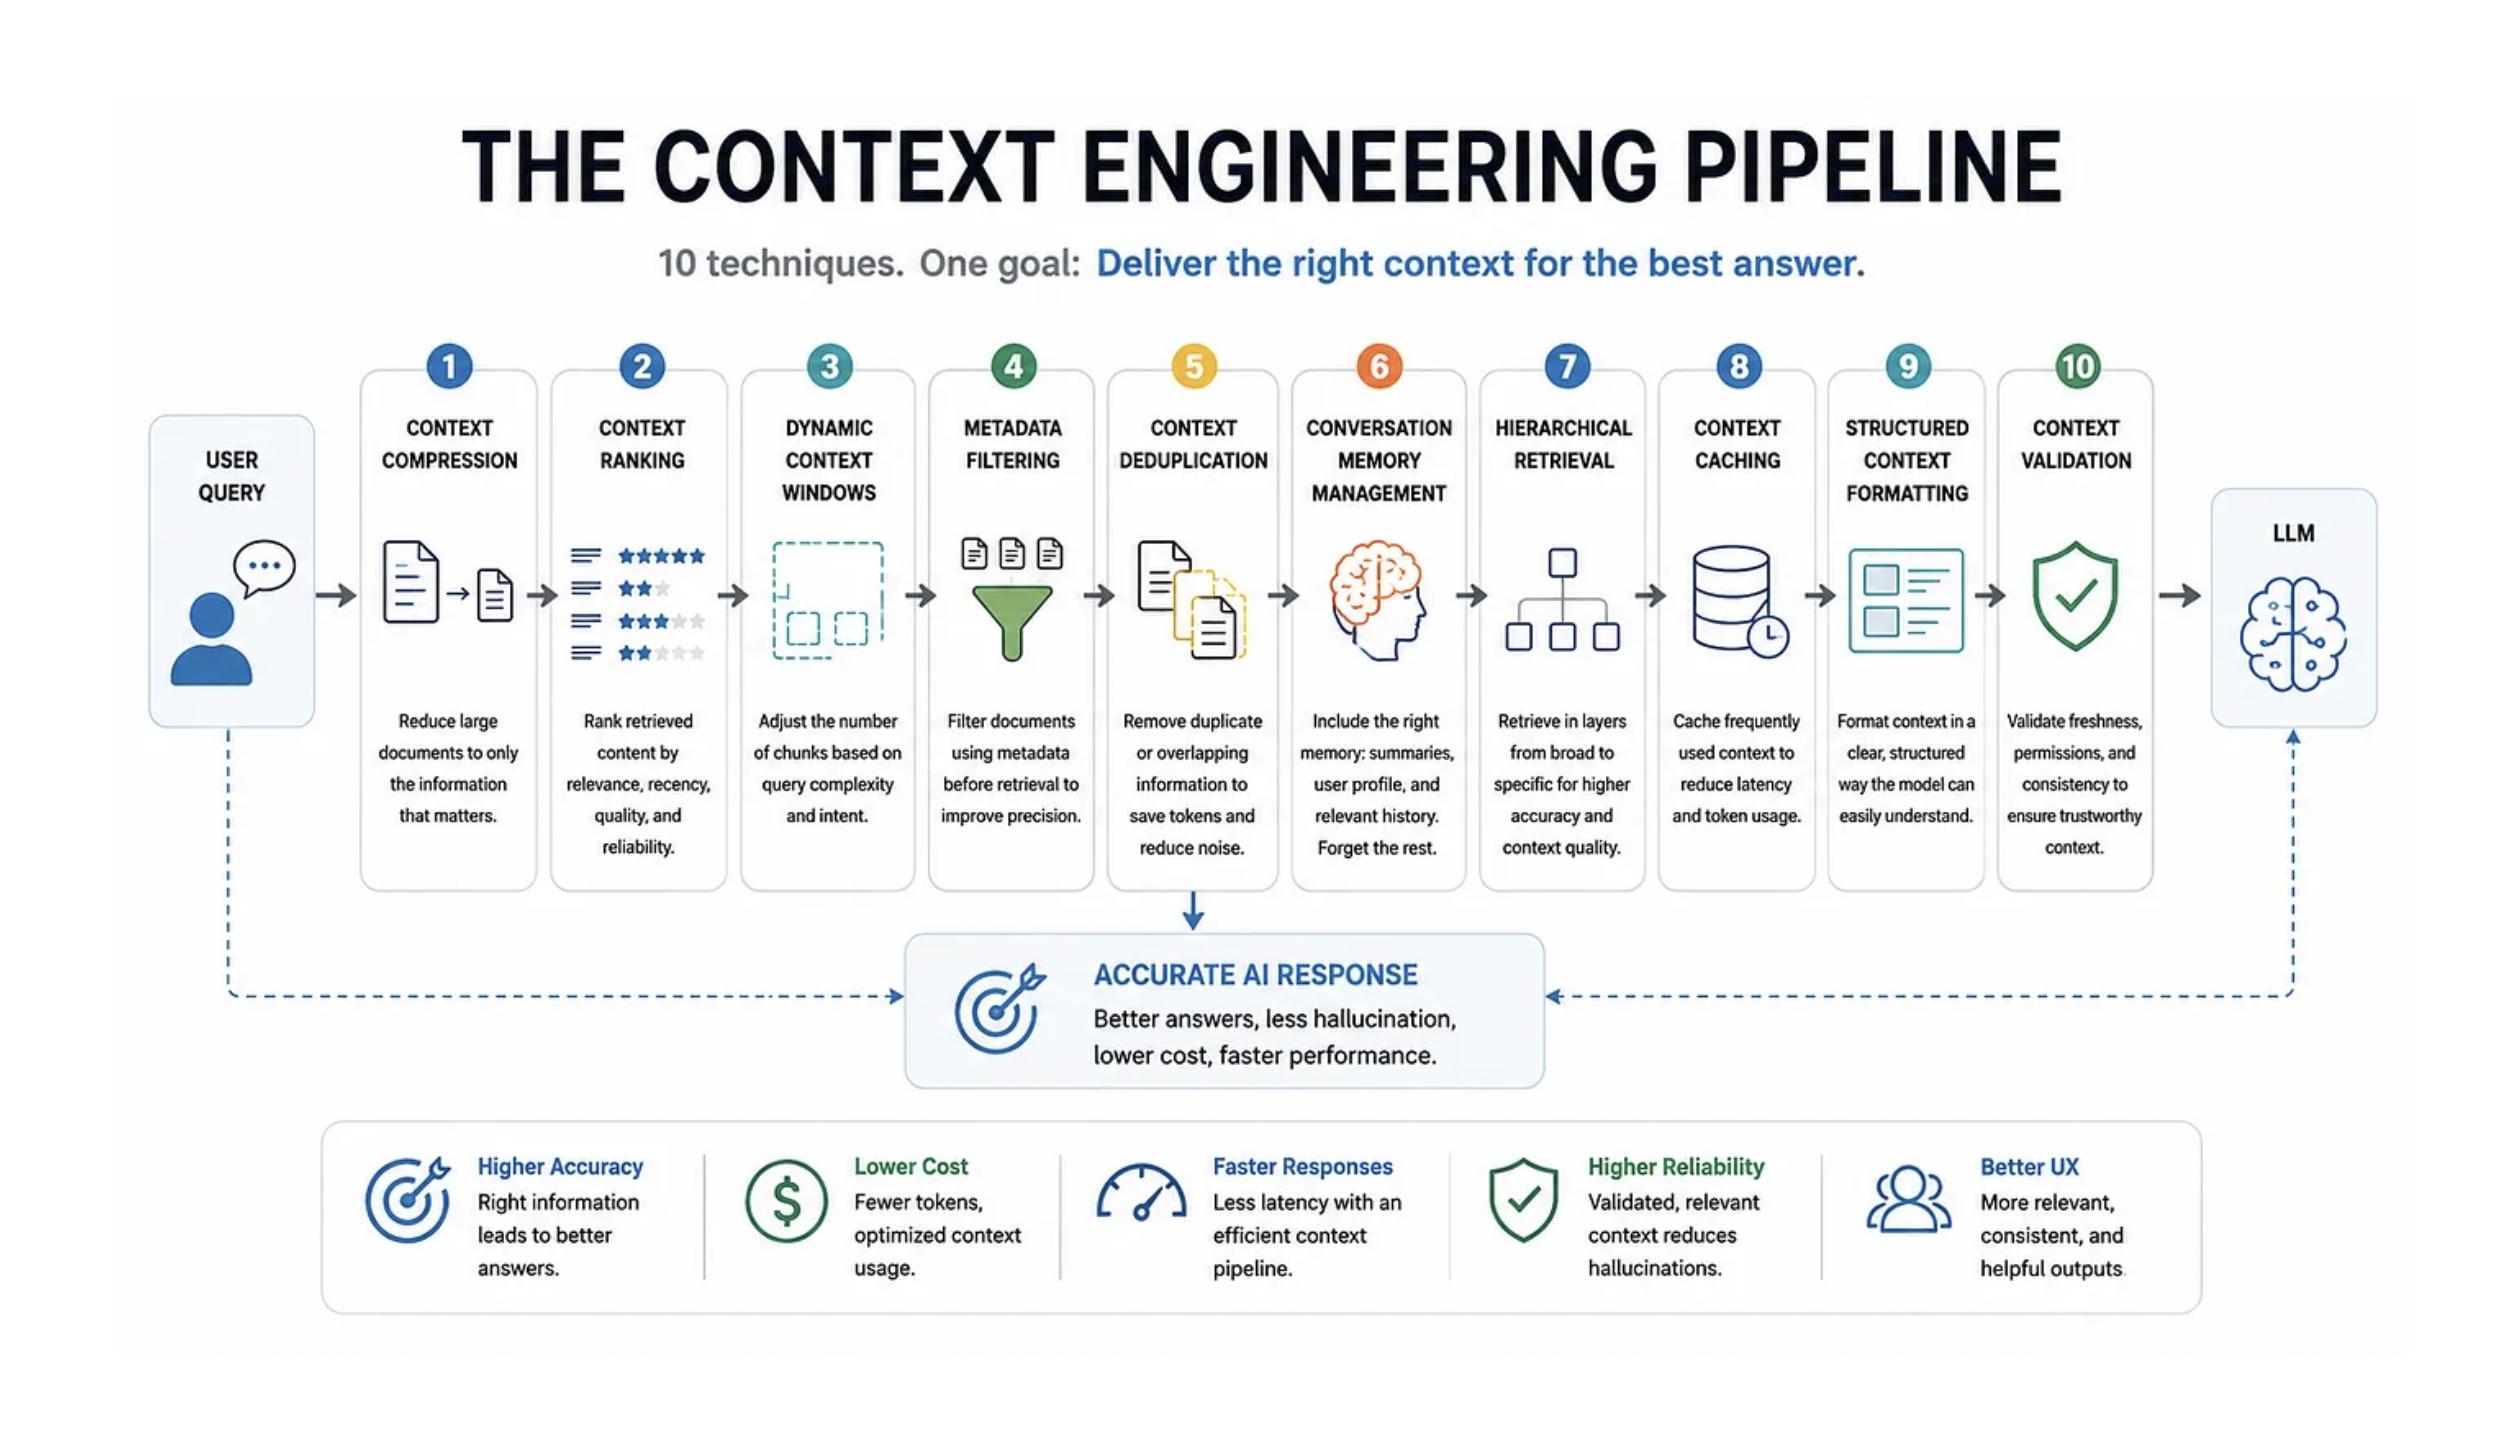
ไม่ว่าคุณกำลังสร้างระบบ RAG, AI Agents, Coding Assistants, Customer Support Bots หรือ Enterprise Copilots คุณภาพของ Context จะเป็นตัวกำหนดคุณภาพของ Output เสมอ
นี่คือเหตุผลที่ Context Engineering กำลังกลายเป็นหนึ่งในทักษะที่สำคัญที่สุดสำหรับ AI Engineer อย่างรวดเร็ว มาเจาะลึก 10 เทคนิคระดับโปรดักชันที่ผ่านการพิสูจน์แล้วว่า ช่วยให้ระบบ AI ทำงานเร็วขึ้น ถูกลง และมีความแม่นยำสูงขึ้นอย่างเห็นได้ชัดกัน
Context Engineering คืออะไร?
Context Engineering คือกระบวนการคัดเลือก จัดระเบียบ บีบอัด และส่งมอบข้อมูลที่ “ถูกต้องที่สุด” ให้กับ LLM (Large Language Model) ก่อนที่มันจะทำการสร้างคำตอบ (Response)
แทนที่จะถามว่า:
“ฉันจะเขียน Prompt ให้ดีขึ้นได้อย่างไร?”
ทีมวิศวกรระดับโปรดักชันจะตั้งคำถามว่า:
- ข้อมูลใดบ้างที่ควรส่งไปให้โมเดล?
- ข้อมูลใดที่ควรถูกตัดทิ้ง?
- ควรจัดลำดับข้อมูลอย่างไร?
- Memory (ประวัติการสนทนา) ส่วนไหนที่ต้องแนบไปด้วย?
- เราจะลดจำนวน Token ได้อย่างไร โดยที่ความหมายยังคงเดิม?
Prompt ที่ดีช่วยได้ แต่ Context ที่ยอดเยี่ยมคือตัวเปลี่ยนเกม
1. Context Compression (การบีบอัดบริบท)
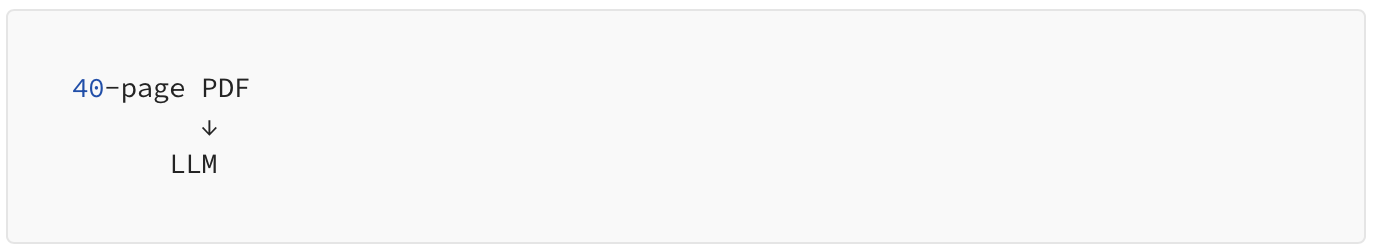
แอปพลิเคชันส่วนใหญ่ผลาญ Token ทิ้งเป็นพัน ๆ ไปกับการโยนเอกสารทั้งฉบับให้โมเดลอ่าน
ให้เปลี่ยนมาใช้วิธี บีบอัดเอกสาร (Compress) ให้เหลือเฉพาะข้อมูลที่เกี่ยวข้องกับคำถามในปัจจุบันแทน
แทนที่จะใช้แบบนี้:
ให้ใช้แบบนี้:
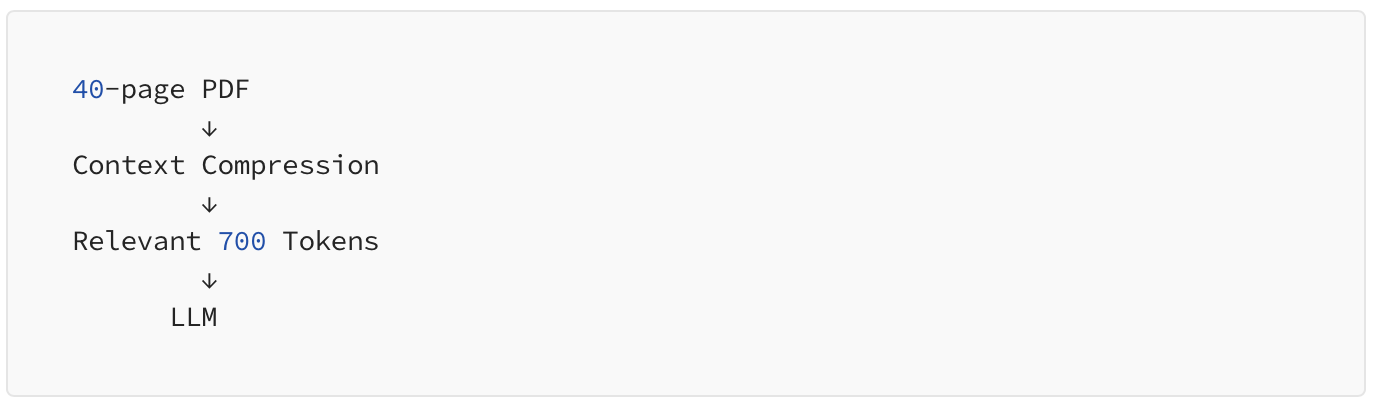
- ข้อดี: ประหยัดค่า Token, Response เร็วขึ้น (ลด Latency), การประมวลผลเหตุผล (Reasoning) ดีขึ้น และช่วยลดอาการ AI หลอน (Hallucinations)
- Production Tip: การใช้โมเดลสรุปความ (Summarization) หรือ Extractive Compression มักจะช่วยลดขนาด Context ลงได้ถึง 70 – 90% โดยไม่สูญเสียข้อมูลสำคัญ
2. Context Ranking (การจัดอันดับบริบท)
ใช่ว่าเอกสารทุกชิ้นที่ดึงมาได้ (Retrieve) จะคู่ควรกับการส่งให้โมเดลอ่าน
หลังจากทำการค้นหา (Retrieval) ให้ทำการจัดอันดับ (Ranking / Reranking) เอกสารโดยอิงจาก:
- ความใกล้เคียงทางความหมาย (Semantic similarity)
- ความสดใหม่ของข้อมูล (Recency)
- ความน่าเชื่อถือของแหล่งที่มา
- สิทธิ์การเข้าถึงของผู้ใช้ (User permissions)
- คุณภาพของเอกสาร
จงส่งเฉพาะผลลัพธ์ที่ได้คะแนนสูงสุดเท่านั้น เพราะการส่งเอกสารระดับกลาง ๆ 10 ชิ้นไปให้โมเดล มักจะให้ผลลัพธ์ที่ “แย่กว่า” การส่งเอกสารคุณภาพเยี่ยมแค่ 3 ชิ้นเสมอ
3. Dynamic Context Windows (การปรับขนาด Context Window แบบไดนามิก)
แอปพลิเคชันส่วนใหญ่มักจะส่ง Context ในปริมาณที่ “เท่าเดิม” เสมอ ซึ่งเป็นวิธีที่ไร้ประสิทธิภาพ
แนวทางที่ดีกว่าคือ การปรับขนาด Context ให้ยืดหยุ่นตาม “ความซับซ้อนของ Task”
ตัวอย่าง:
- คำถาม FAQ ทั่วไป > ใช้ข้อมูล 2 Chunks
- การเปรียบเทียบสเปก Product > ใช้ข้อมูล 6 Chunks
- การแก้ปัญหาทางเทคนิค (Troubleshooting) > ใช้ข้อมูล 12 Chunks
วิธีนี้ช่วยลด Latency ในจังหวะที่ไม่จำเป็น และช่วยเพิ่มคุณภาพคำตอบในงานที่ซับซ้อน
4. Metadata Filtering (การคัดกรองด้วย Metadata)
ในหลาย ๆ ครั้ง Metadata สำคัญกว่า Embeddings
แทนที่จะทำการค้นหาจากเอกสารทั้งหมด ให้ฟิลเตอร์ด้วย Metadata ก่อนเป็นอันดับแรก
ตัวอย่างการฟิลเตอร์:
- แผนก (Department)
- โปรดักต์ (Product)
- ภูมิภาค / ภาษา
- เวอร์ชัน / วันที่เผยแพร่
- ระดับความปลอดภัย
การฟิลเตอร์ด้วย Metadata จะช่วยเพิ่มความแม่นยำ (Accuracy) ในการทำ Retrieval ได้อย่างมหาศาล ก่อนที่ระบบจะเริ่มทำ Similarity Search (ค้นหาด้วย Vector) เสียอีก
5. Context Deduplication (การลบข้อมูลซ้ำซ้อน)
ระบบ Retrieval มักจะดึง Chunks ที่มีข้อมูลทับซ้อนกันมา ข้อมูลที่ซ้ำซ้อนเหล่านี้ทำให้เปลืองพื้นที่ Context อันมีค่า
ก่อนที่จะส่งข้อมูลให้ LLM คุณควร:
- ลบข้อความ (Passages) ที่ซ้ำกันออก
- ผสาน (Merge) Chunks ที่ทับซ้อนกันให้เป็นก้อนเดียว
- เก็บไว้เฉพาะข้อมูลที่ไม่ซ้ำ (Unique) เท่านั้น
พื้นที่ที่มีแต่ข้อมูล Unique จะช่วยให้โมเดลมีพื้นที่สำหรับประมวลผล (Reasoning) ที่ดีขึ้น
6. Conversation Memory Management (การบริหารจัดการหน่วยความจำแชท)
ประวัติแชทเก่า ๆ ไม่ควรถูกเก็บและส่งไปหาโมเดลตลอดกาล ระบบ AI ที่ดีต้องจัดการ Memory อย่างชาญฉลาด
กลยุทธ์ที่นิยมใช้:
- Short-term memory (ความจำระยะสั้น)
- Long-term memory (ความจำระยะยาว)
- User profile memory (จำบริบทของตัวผู้ใช้)
- Session summaries (บทสรุปรายเซสชัน)
- Forgetting (การสั่งให้ลบข้อมูลที่ล้าสมัยทิ้ง)
แทนที่จะส่งประวัติแชท 100 ข้อความก่อนหน้า ให้ส่งเป็น “Conversation Summary” (บทสรุปการสนทนา) ที่กระชับแทน
7. Hierarchical Retrieval (การดึงข้อมูลแบบลำดับชั้น)
หากคุณมีคลังเอกสารขนาดใหญ่ อย่าพึ่งพาการค้นหาแบบระนาบเดียว (Flat Retrieval) ให้ใช้การค้นหาแบบหลายขั้นตอน (Multi-stage) แทน
ตัวอย่าง Workflow:
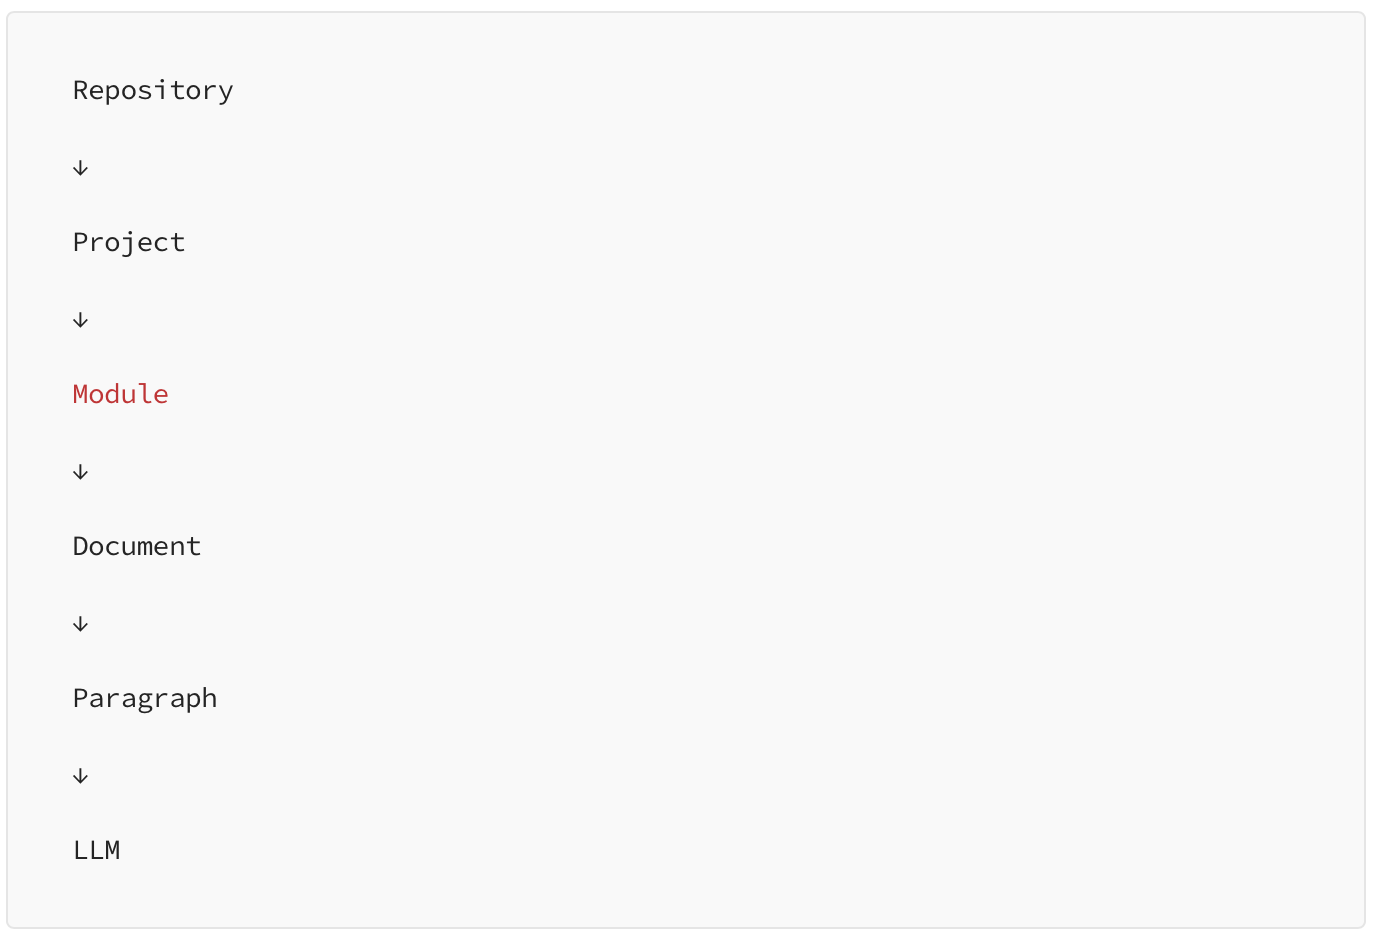
แต่ละ Stage จะช่วยตีกรอบพื้นที่การค้นหา (Search Space) ให้แคบลง ช่วยเพิ่มทั้งความเร็ว (Speed) และความแม่นยำ (Precision) วิธีนี้เวิร์คมากสำหรับการทำ Enterprise Knowledge Base และ Code Assistants
8. Context Caching (การทำแคชชิงบริบท)
User จำนวนมากมักจะถามคำถามซ้ำ ๆ กัน แทนที่จะ Generate Context เดิมซ้ำแล้วซ้ำเล่า ให้จับมันทำ Cache
ข้อมูลที่ควรทำ Cache:
- Document ของ Product / นโยบายบริษัท
- API References / คู่มือที่ถูกเปิดอ่านบ่อย ๆ
ข้อดี: ลด Latency, ประหยัดการใช้ Token และลดค่าใช้จ่ายด้าน Infrastructure ลงอย่างมหาศาล (ระบบระดับโปรดักชันหลายแห่งประหยัดเงินได้เป็นกอบเป็นกำจากการทำ Caching ที่มีประสิทธิภาพ)
9. Structured Context Formatting (การจัดฟอร์แมตบริบทอย่างมีโครงสร้าง)
ข้อมูลชุดเดียวกัน อาจให้ผลลัพธ์ต่างกันมาก ขึ้นอยู่กับ “วิธี” ที่คุณนำเสนอให้โมเดล
หลีกเลี่ยงการสาด Raw Text ดิบ ๆ ใส่โมเดล แต่ให้จัดระเบียบ Context ให้ชัดเจน (เช่น ใช้ Markdown)
ตัวอย่าง: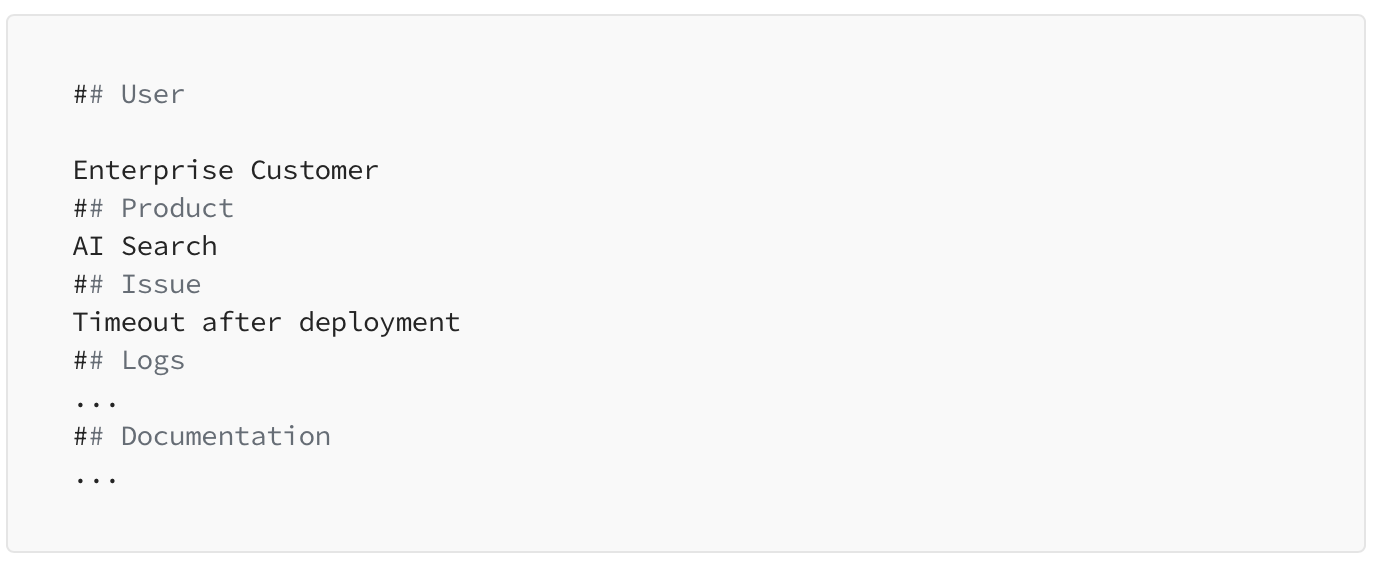 โครงสร้างที่ชัดเจนจะช่วยให้โมเดลเข้าใจ “ความสัมพันธ์” ของข้อมูลแต่ละส่วนได้ดีขึ้นมาก
10. Context Validation (การตรวจสอบความถูกต้องของบริบท)
อย่าคิดเอาเองว่าข้อมูลที่ Retrieve มาจะถูกต้องเสมอ ก่อนส่ง Context ให้โมเดล ควรตรวจสอบ:
- นำเอกสารที่ล้าสมัย (Outdated) ออก
- ตรวจสอบสิทธิ์การเข้าถึง (Permissions)
- ตรวจจับข้อมูลที่ขัดแย้งกันเอง
- ตรวจสอบความสดใหม่ (Freshness) และอ้างอิง (Citations)
Context ที่แย่ คือสาเหตุอันดับต้น ๆ ของอาการ Hallucinations ในระบบ Production
จำไว้เสมอว่า Garbage in. Garbage out. (ใส่ขยะเข้าไป ก็ได้ขยะออกมา)
Production Context Pipeline
แอปพลิเคชัน AI ยุคใหม่ มักจะมี Flow การทำงานดังนี้:
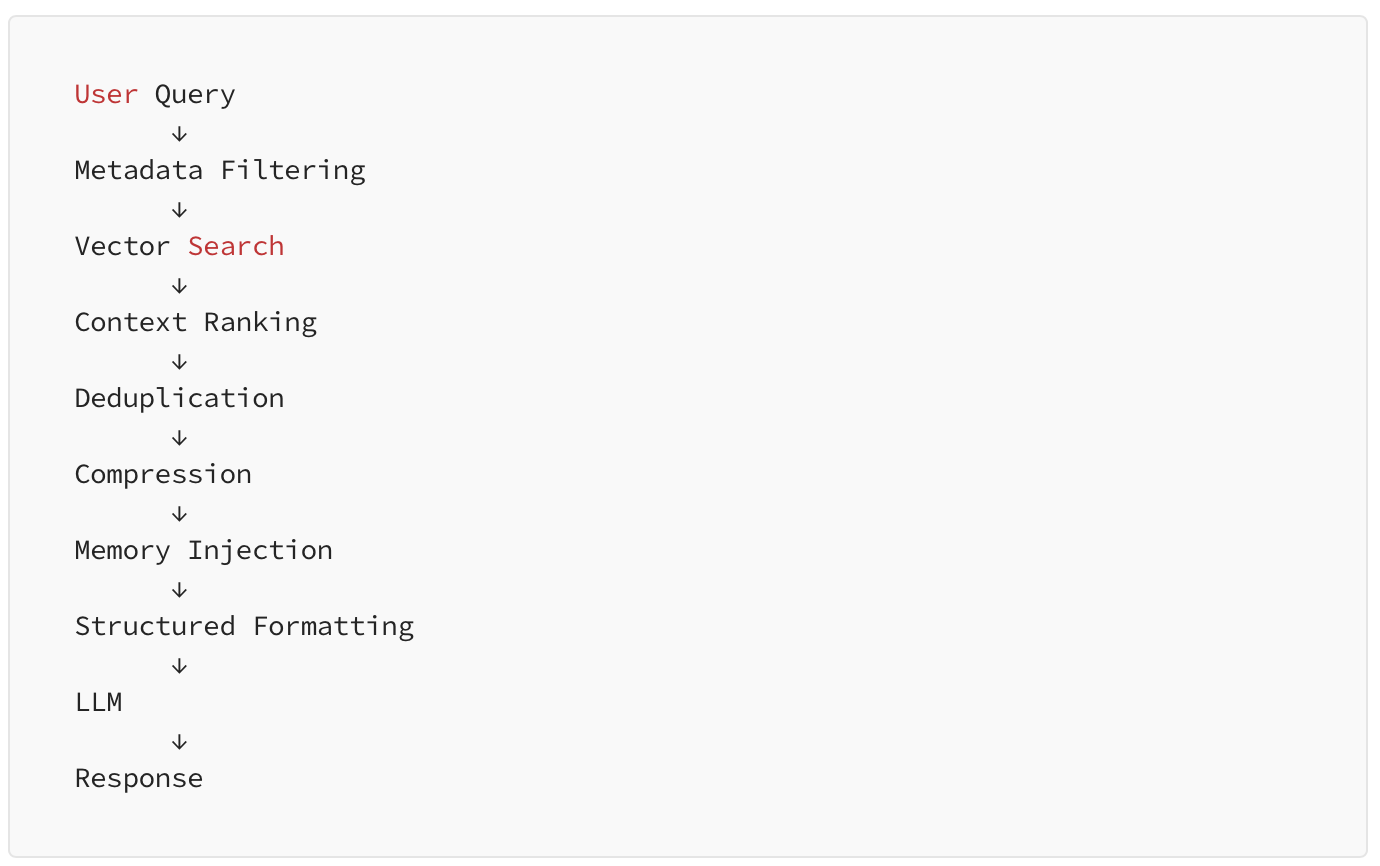
สังเกตไหมว่า LLM เป็นแทบจะขั้นตอนสุดท้าย? ความฉลาดส่วนใหญ่เกิดขึ้นก่อนที่โมเดลจะ Generate Token แรกเสียอีก
Common Mistakes (ข้อผิดพลาดที่พบได้บ่อย)
- ส่งเอกสารให้โมเดลอ่านทั้งฉบับ
- มองข้ามความสำคัญของ Metadata
- แนบประวัติแชทไปทุกข้อความแบบไม่จำกัด
- ไม่มีกระบวนการ Reranking
- มี Context ที่ซ้ำซ้อนกันเต็มไปหมด
- ยัดเอกสารที่ไม่เกี่ยวข้องกันมาปนกัน
- มีข้อมูลที่ล้าสมัยหลงเหลืออยู่
- จัด Format ข้อความแบบไม่ใส่ใจ
Quick Summary
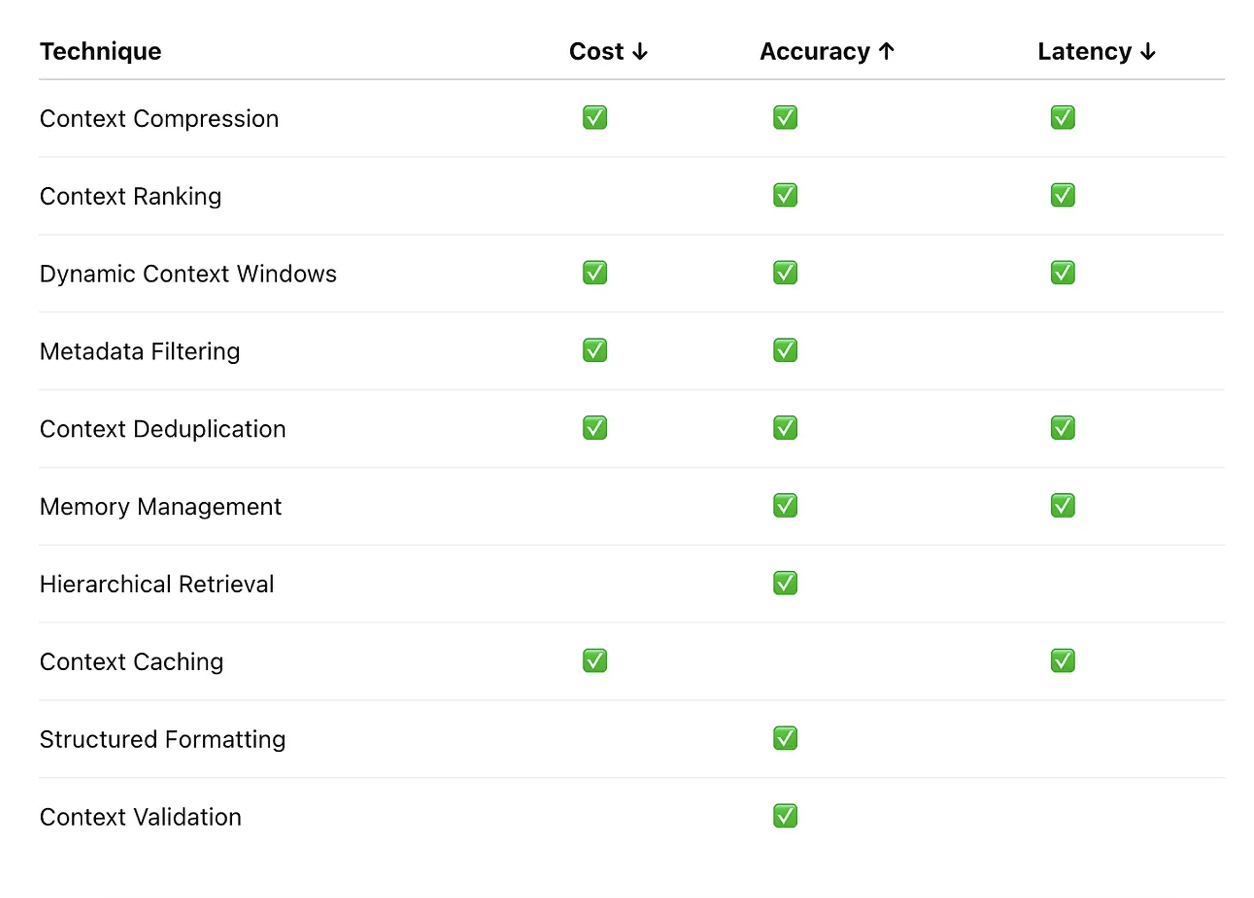
บทส่งท้าย
Prompt Engineering ไม่ได้หายไปไหน แต่มัน “ไม่เพียงพอ” อีกต่อไป
เมื่อแอปพลิเคชัน AI มีความซับซ้อนมากขึ้น ความได้เปรียบทางการแข่งขันจะมาจากการส่งมอบ Context ที่ถูกต้อง ไม่ใช่แค่การเขียน Prompt ที่ฉลาด ทีมวิศวกรที่สร้างระบบ AI ที่เสถียรที่สุด ล้วนลงทุนลงแรงไปกับระบบ Retrieval, Memory, Ranking, Compression และ Validation มากกว่าการมานั่งปรับแต่ง Prompt
หากคุณกำลังพัฒนาระบบ AI ระดับ Production จงยกระดับการจัดการ Context ให้เป็น “ปัญหาทางวิศวกรรมอันดับหนึ่ง (First-class engineering problem)” เพราะ Context ที่ดีกว่า ไม่ได้ช่วยแค่ให้ Response ดีขึ้น แต่มันช่วยให้ “ทุกอย่าง” ดีขึ้น
และทั้งหมดนี้คือ 10 เทคนิค Context Engineering ที่ AI Engineer ต้องรู้
เมื่อ หางาน IT ให้ ISM Technology Recruitment เป็นอีกหนึ่งตัวช่วย เพื่อให้คุณได้ “ชีวิตการทำงานในแบบที่คุณต้องการ” เพียงส่ง Resume มาที่นี่
ISM เชี่ยวชาญในธุรกิจ IT Recruitment & IT Outsourcing โดยเฉพาะ ได้เปิดทำการมาแล้วกว่า 30 ปี มีพนักงานทุกสายและทุกระดับทางด้าน IT ที่ได้ร่วมงานกับลูกค้าองค์กรใหญ่ที่มีชื่อเสียงและบริษัทข้ามชาติมากมาย
Source: https://ai.plainenglish.io/